Opus 5 的意义,不是“又一个最强模型”
2026年7月24日,Anthropic 正式发布 Claude Opus 5。最容易传播的说法是:它拥有接近 Fable 5 的能力,只收一半的价格。但如果只把它理解成“Fable 平替”,就会错过这次发布真正重要的部分。
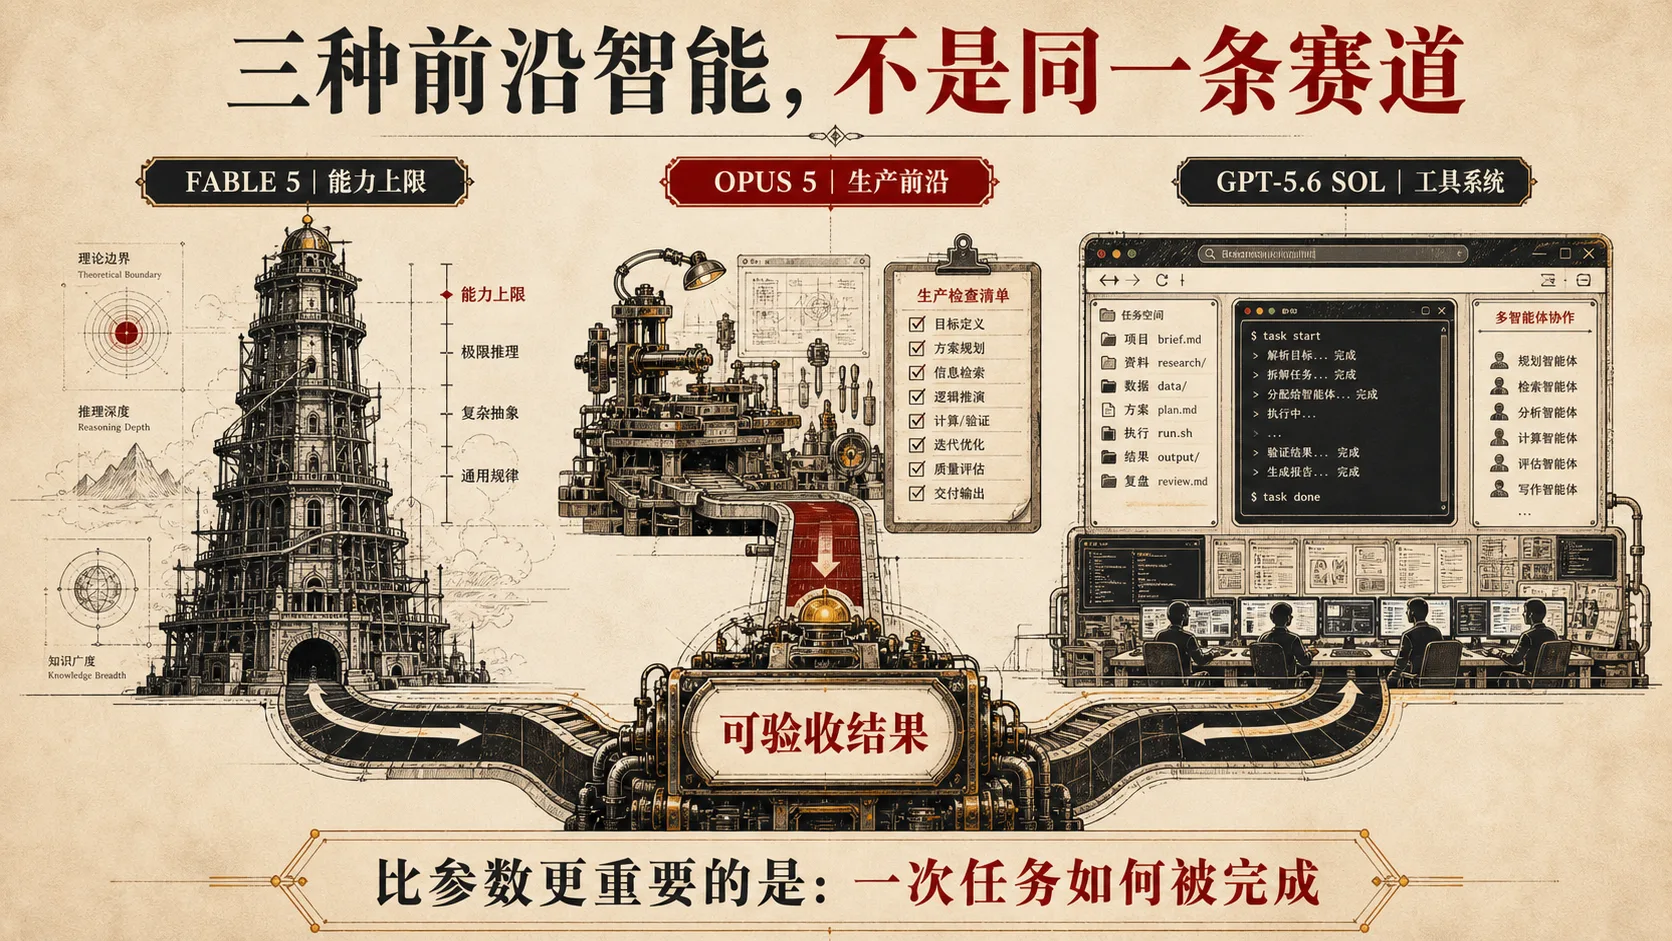
过去两个月,前沿模型市场出现了一次很清晰的分层:Fable 5 把能力上限往前推;GPT‑5.6 Sol 把浏览、电脑操作、文件、代码、图像和多智能体整合成一套更完整的执行系统;Opus 5 则试图占领两者之间最有商业价值的位置——让足够强的智能,以可预测的成本和努力档位,持续完成日常最难的生产任务。
适合极少数、极困难、长周期、容错率低的研究与工程任务。
你为“多一点上限”付费。
用五档努力、较低单价和更主动的执行风格,覆盖复杂编码、知识工作和业务自动化。
你为“稳定完成难事”付费。
把模型放进浏览器、终端、文件、电脑操作、图像和多智能体运行时中。
你为“跨工具交付结果”付费。
因此,“谁更强”这个问题只有在你补上任务、工具、预算、时间、验收标准之后才有意义。脱离运行时谈模型,已经越来越像脱离操作系统谈芯片:并非错误,但不足以解释真实体验。
Opus 5 到底好在哪里?
它把“最高能力”改造成了一条可调的生产曲线
官方将 Opus 5 定位为“thoughtful and proactive”。这两个词比“更聪明”更准确:它更愿意检查上下文、补测试、找根因、验证结果,也更容易主动扩展任务。
资料来源:Anthropic 2026年7月24日发布页。图片为官方视觉,文字为本文分析。
第一,接近最高能力,但成本进入主力生产区
Opus 5 的 API 公开价为每百万输入 Token 5 美元、输出 25 美元;Fable 5 为 10/50 美元。两者都提供 100 万上下文和最高 12.8 万输出。定价直接减半,并不意味着每个任务成本一定减半——模型会使用多少思考 Token、调用多少工具、是否重试,都会改变账单——但它确实让更多团队可以把 Opus 作为默认复杂任务模型,而不只是故障升级时的“奢侈品”。
第二,五档 effort 不是参数选项,而是一条新的产品曲线
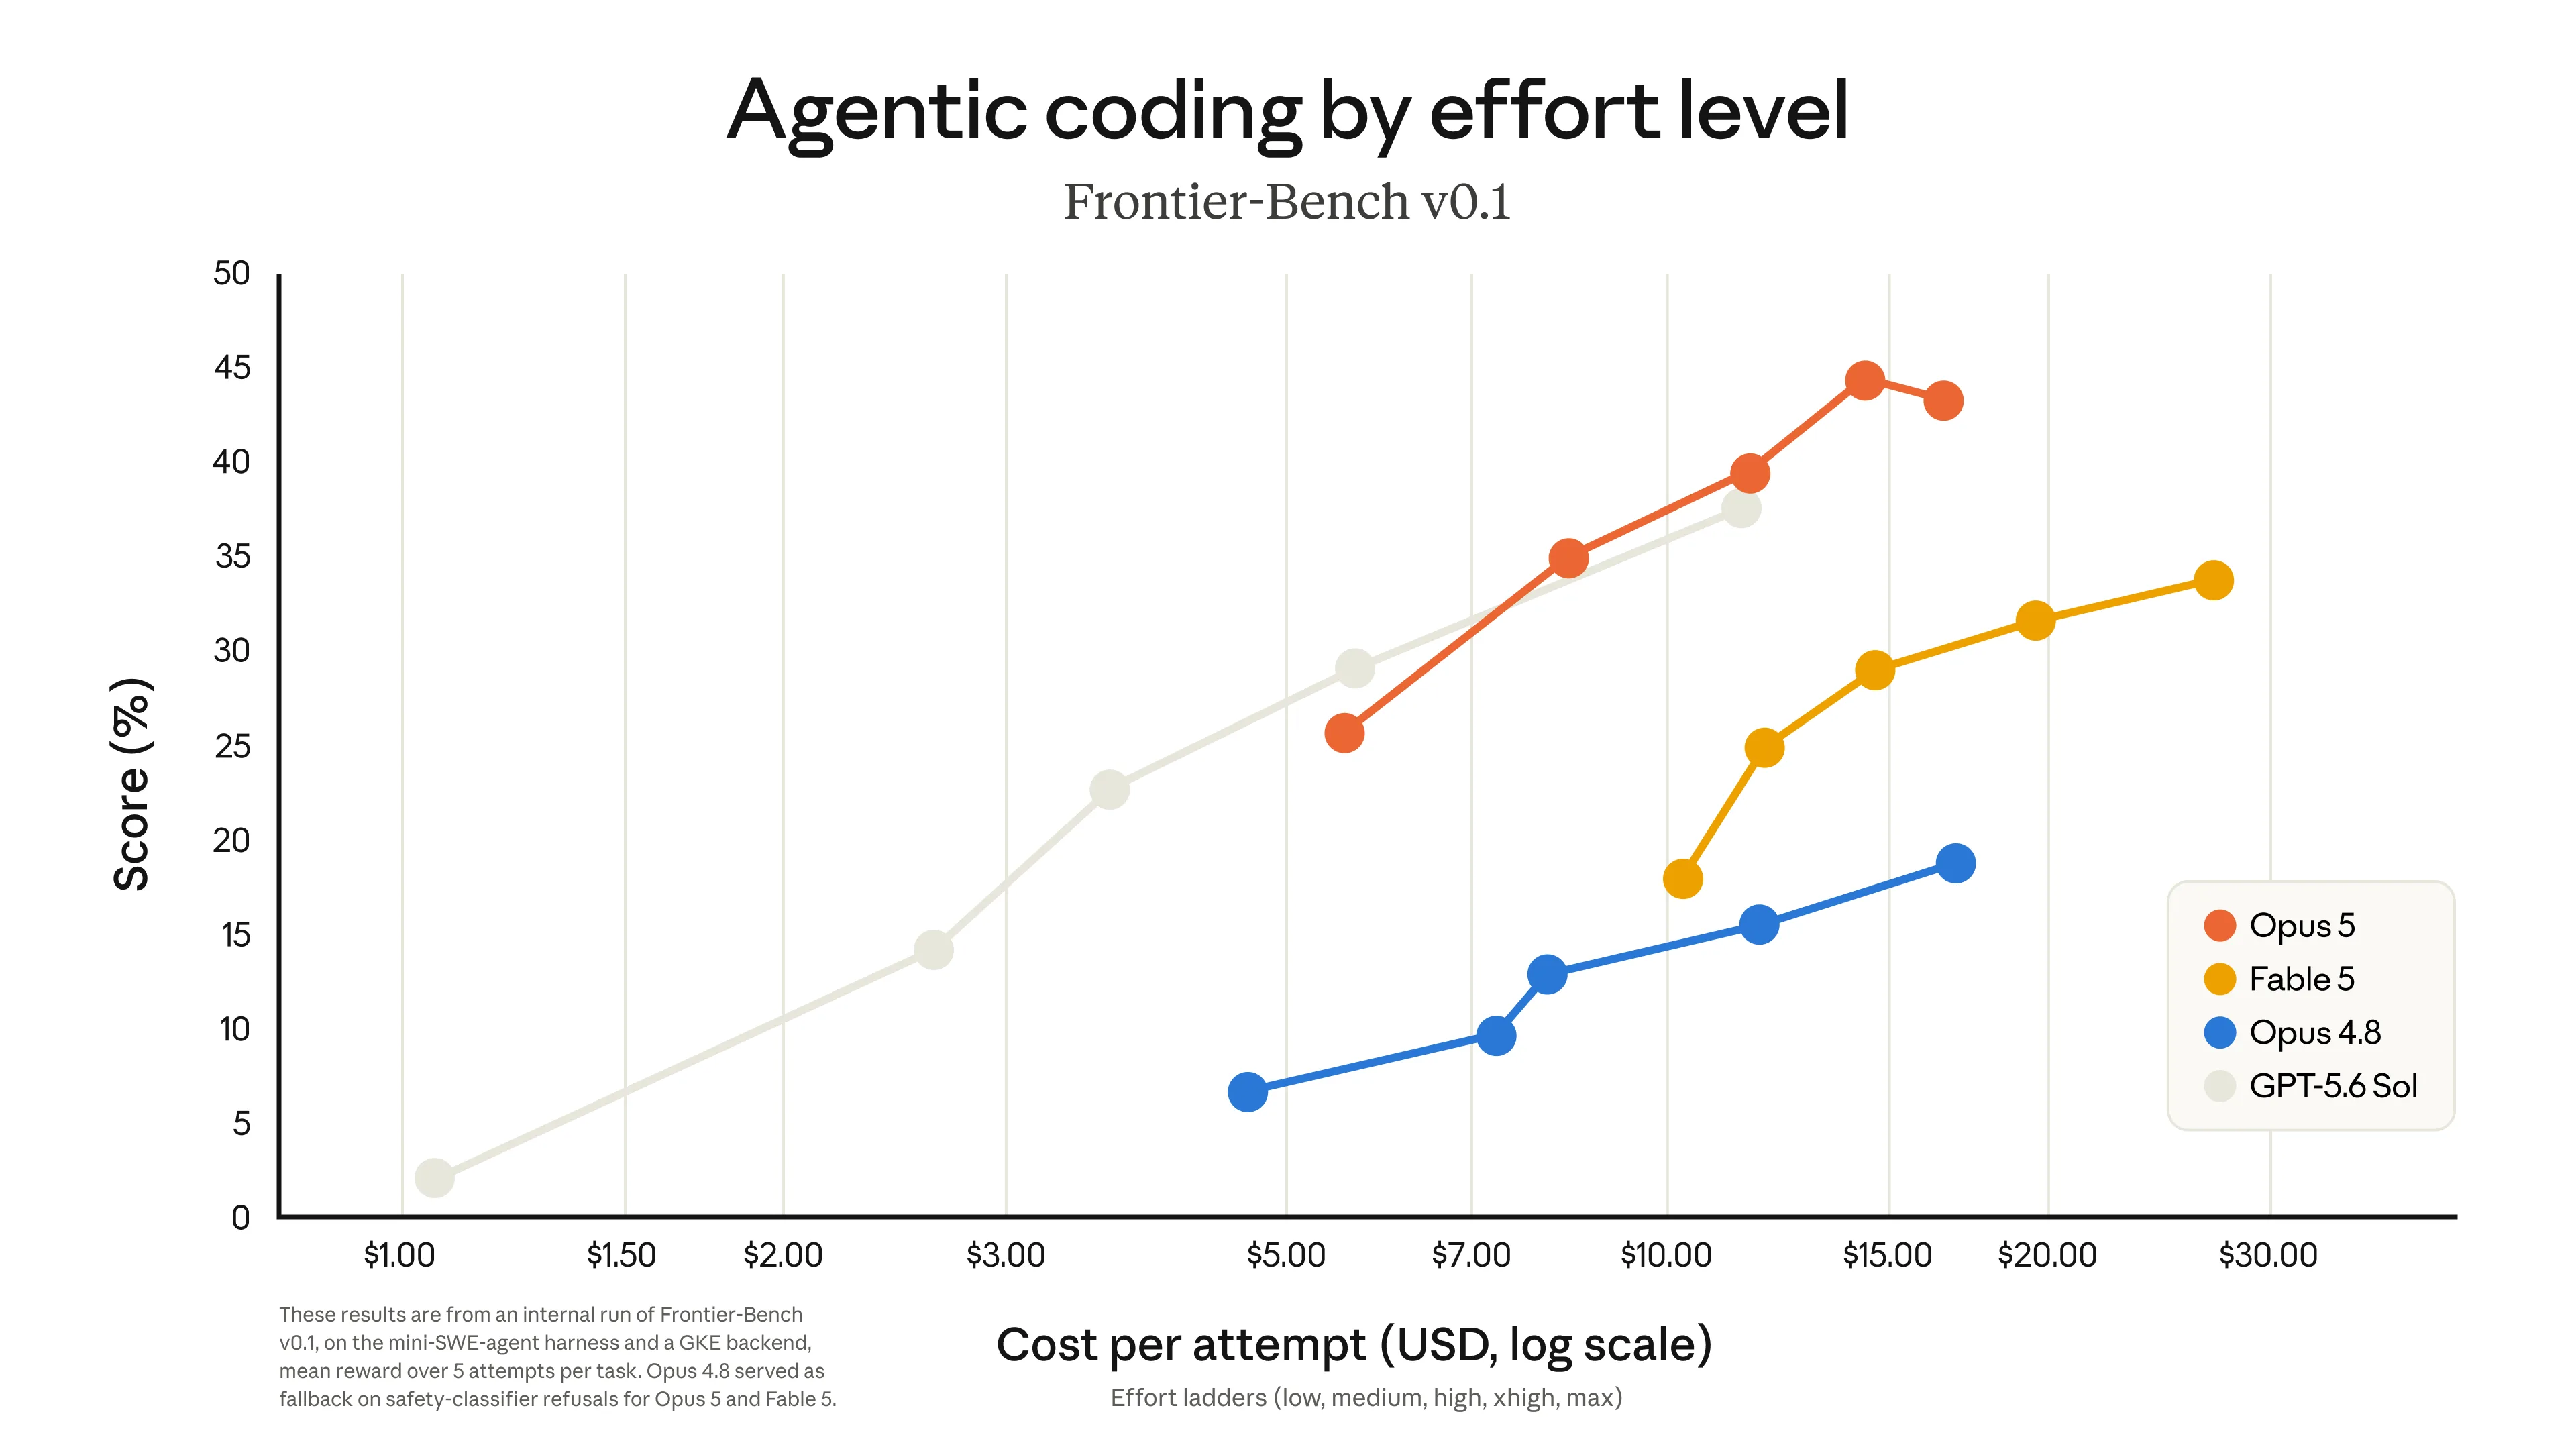
Opus 5 提供 low、medium、high、xhigh、max 五档努力级别,API 与 Claude Code 默认 high。低档让它用较少推理处理常规工作,高档让它在复杂工程、研究和跨工具任务中投入更多计算。独立测评显示,从 low 到 max 的输出 Token 使用量可相差约八倍。换句话说,Opus 5 不是一个固定点,而是一条“质量—成本—时间”曲线。
第三,它优化的不是答题,而是“收尾能力”
Anthropic 展示的案例重点并非代码能不能写,而是能否发现根因、补建测试支架、验证修复、处理缺失数据、在工具变化后继续执行。对企业而言,这类差异很关键:真正昂贵的不是模型少写一段代码,而是它留下一个表面可运行、实际不可验收的半成品。
第四,工具可以在对话中变化
Opus 5 推出对话中工具变化的测试能力,并支持服务端自动回退。前者意味着长任务运行过程中可以新增或替换工具,不必完全重启上下文;后者则意味着你在产品层实际使用的“Claude”,有时可能由不同模型共同完成。它提高了连续性,也再次提醒我们:用户体验到的是一个编排系统,不再只是一个模型权重。
第五,它更主动,也更容易“做多了”
Anthropic 自己在提示词指南中承认:Opus 5 更倾向于解释过程、反复验证、扩大范围和委派子任务。对于复杂项目,这是优势;对于边界严格的修改,它可能变成额外成本。使用时应该明确写出:只修改哪些文件、何时停止、是否允许重构、最多调用几次工具、什么算完成。
不是三台发动机,而是三套不同的整车
今天再用“参数量、上下文、榜单分数”理解模型,已经不够了。用户真正接触到的,是基础模型、推理努力、工具、记忆、多智能体、安全分类、回退模型和验收机制共同组成的产品。
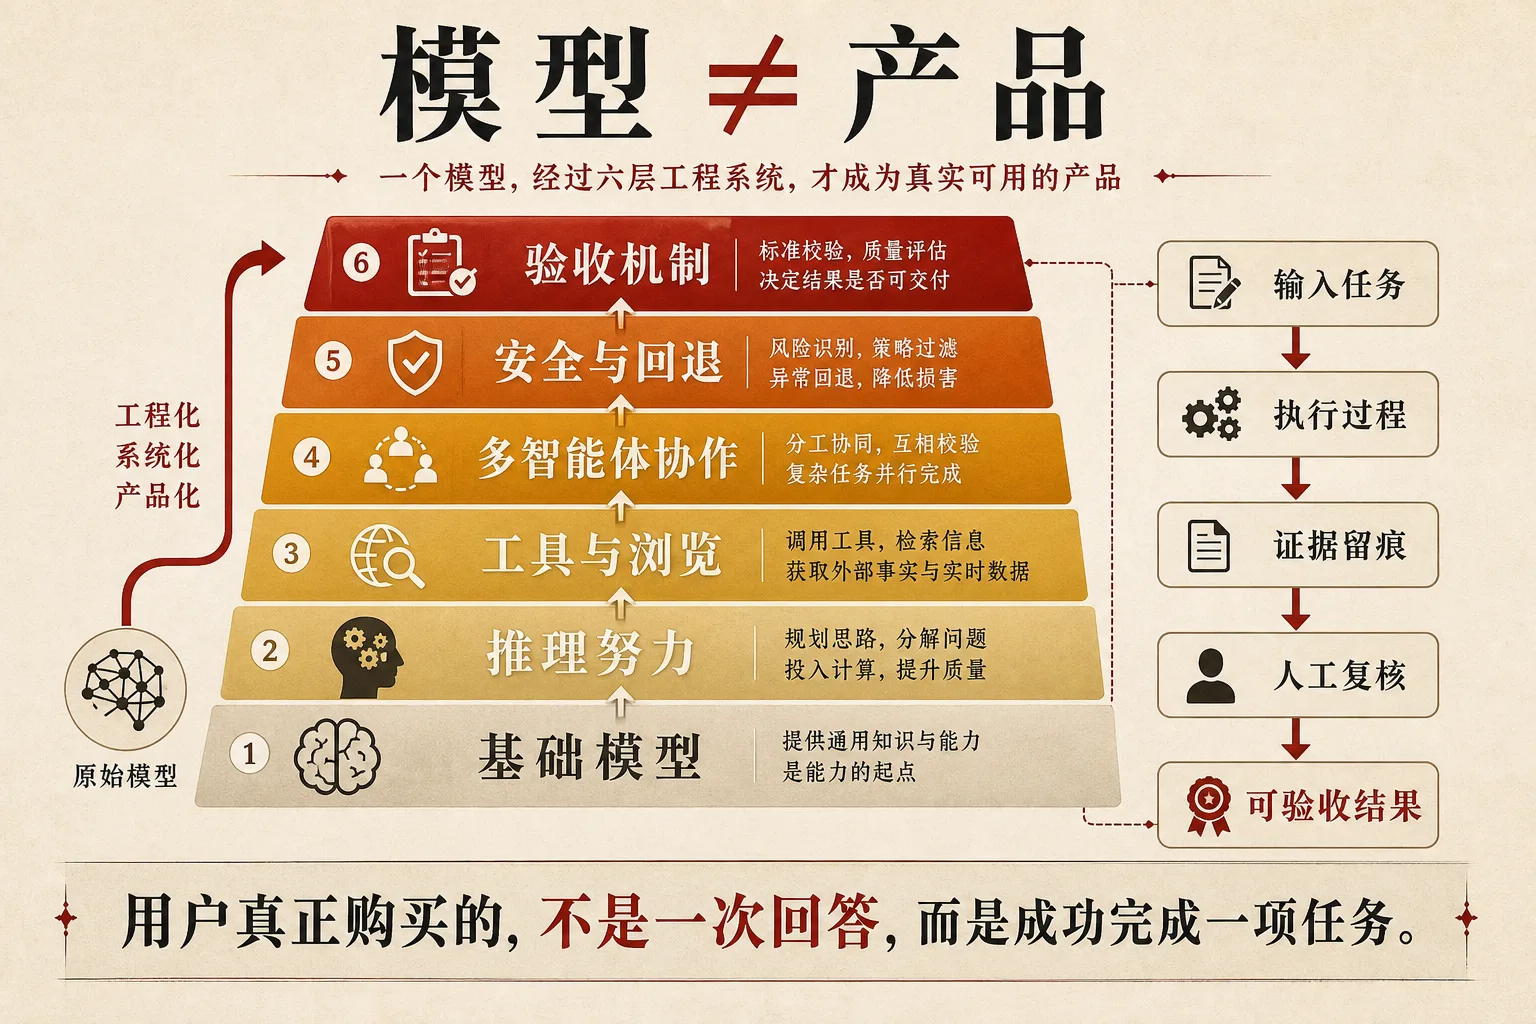
Fable 5 与 Mythos 5 使用同一底层模型,但通过安全分类和回退机制向公众开放。它追求的是在最难、最长、最陌生任务上的能力上限。代价是更高价格、更慢速度,以及在网络安全、生物化学、模型蒸馏等敏感查询上更严格的路由。
Opus 5 并不在每个指标上击败 Fable,但通过半价定价、五档 effort、较低摩擦的安全策略、代码审查和业务自动化能力,把大量原本需要“最高模型”的工作移入日常生产。
GPT‑5.6 Sol 的差异不仅在模型,而在 Responses API 的工具面:网页搜索、文件搜索、图像生成、代码解释器、Hosted Shell、Apply Patch、Skills、Computer Use、MCP、Tool Search 与多智能体协作。它更像一套可编排的智能操作系统。
这也解释了为什么同一榜单会出现相反结论:如果测试只允许文本回答,模型本体占主导;如果允许浏览、终端、文件和多智能体,运行时就会改变结果;如果测试又限制时间和成本,effort 与工具调用策略会再次改变排名。所谓“最强模型”,本质上是一个条件句。
先把能直接比较的事实放在一张表里
| 维度 | Fable 5 | Opus 5 | GPT‑5.6 Sol |
|---|---|---|---|
| 正式发布 | 2026-06-09 | 2026-07-24 | 2026-07-09 |
| 公开定位 | Anthropic 广泛开放的最高能力模型;与 Mythos 5 同底模 | 面向日常复杂任务的主动型前沿模型 | OpenAI 5.6 系列旗舰,强调性能/成本和端到端工作 |
| 输入 / 输出价 | $10 / $50 | $5 / $25 | $5 / $30;缓存输入 $0.50 |
| 长上下文 | 1M / 128K 输出 | 1M / 128K 输出 | 1.05M / 128K 输出 |
| 知识截止 | 2026-01 | 2026-05 | 2026-02-16 |
| 努力控制 | 自适应思考,面向高复杂度 | low 至 max 五档;high 默认 | 多档 reasoning;ultra 可协调并行 Agent |
| 速度选项 | 官方标注较慢 | 常规中速;Fast 约 2.5× 速度、2× Token 单价 | 常规与不同 reasoning 档位;具体延迟取决于运行时 |
| 强项重心 | 长周期研究、复杂推理、视觉与科学问题 | Agent 编码、代码审查、知识工作、业务流程 | 工具调用、浏览、终端、电脑操作、设计与可编辑交付物 |
| 安全产品形态 | 敏感请求分类并可能回退 Opus 4.8 | 更少介入;被标记请求仍可能回退 | 模型与产品政策、工具权限、组织控制共同约束 |
| 重要价格注释 | 高思考和长任务提高实际成本 | effort 与 Fast 改变实际成本 | 超过 272K 的提示按整次请求提高输入与输出费率 |
价格单位均为每百万 Token 美元;公开价不含工具、存储、网络、失败重试与人工复核成本。参数与价格截至 2026-07-25,以官方 API 文档为准。
三家公司都能证明自己赢了——这恰恰说明不能只看一张表
Anthropic 的发布页把 Opus 5 放在 Frontier‑Bench、GDPval‑AA v2、ARC‑AGI‑3、BrowseComp、OSWorld、AutomationBench 等多项领先位置。OpenAI 的发布页则显示 Sol 在 Agents’ Last Exam、TerminalBench、BrowseComp 等任务上强势,并在自己的表格里保留了 Fable 在 SWE‑Bench Pro 和 GDPval‑AA 的优势。
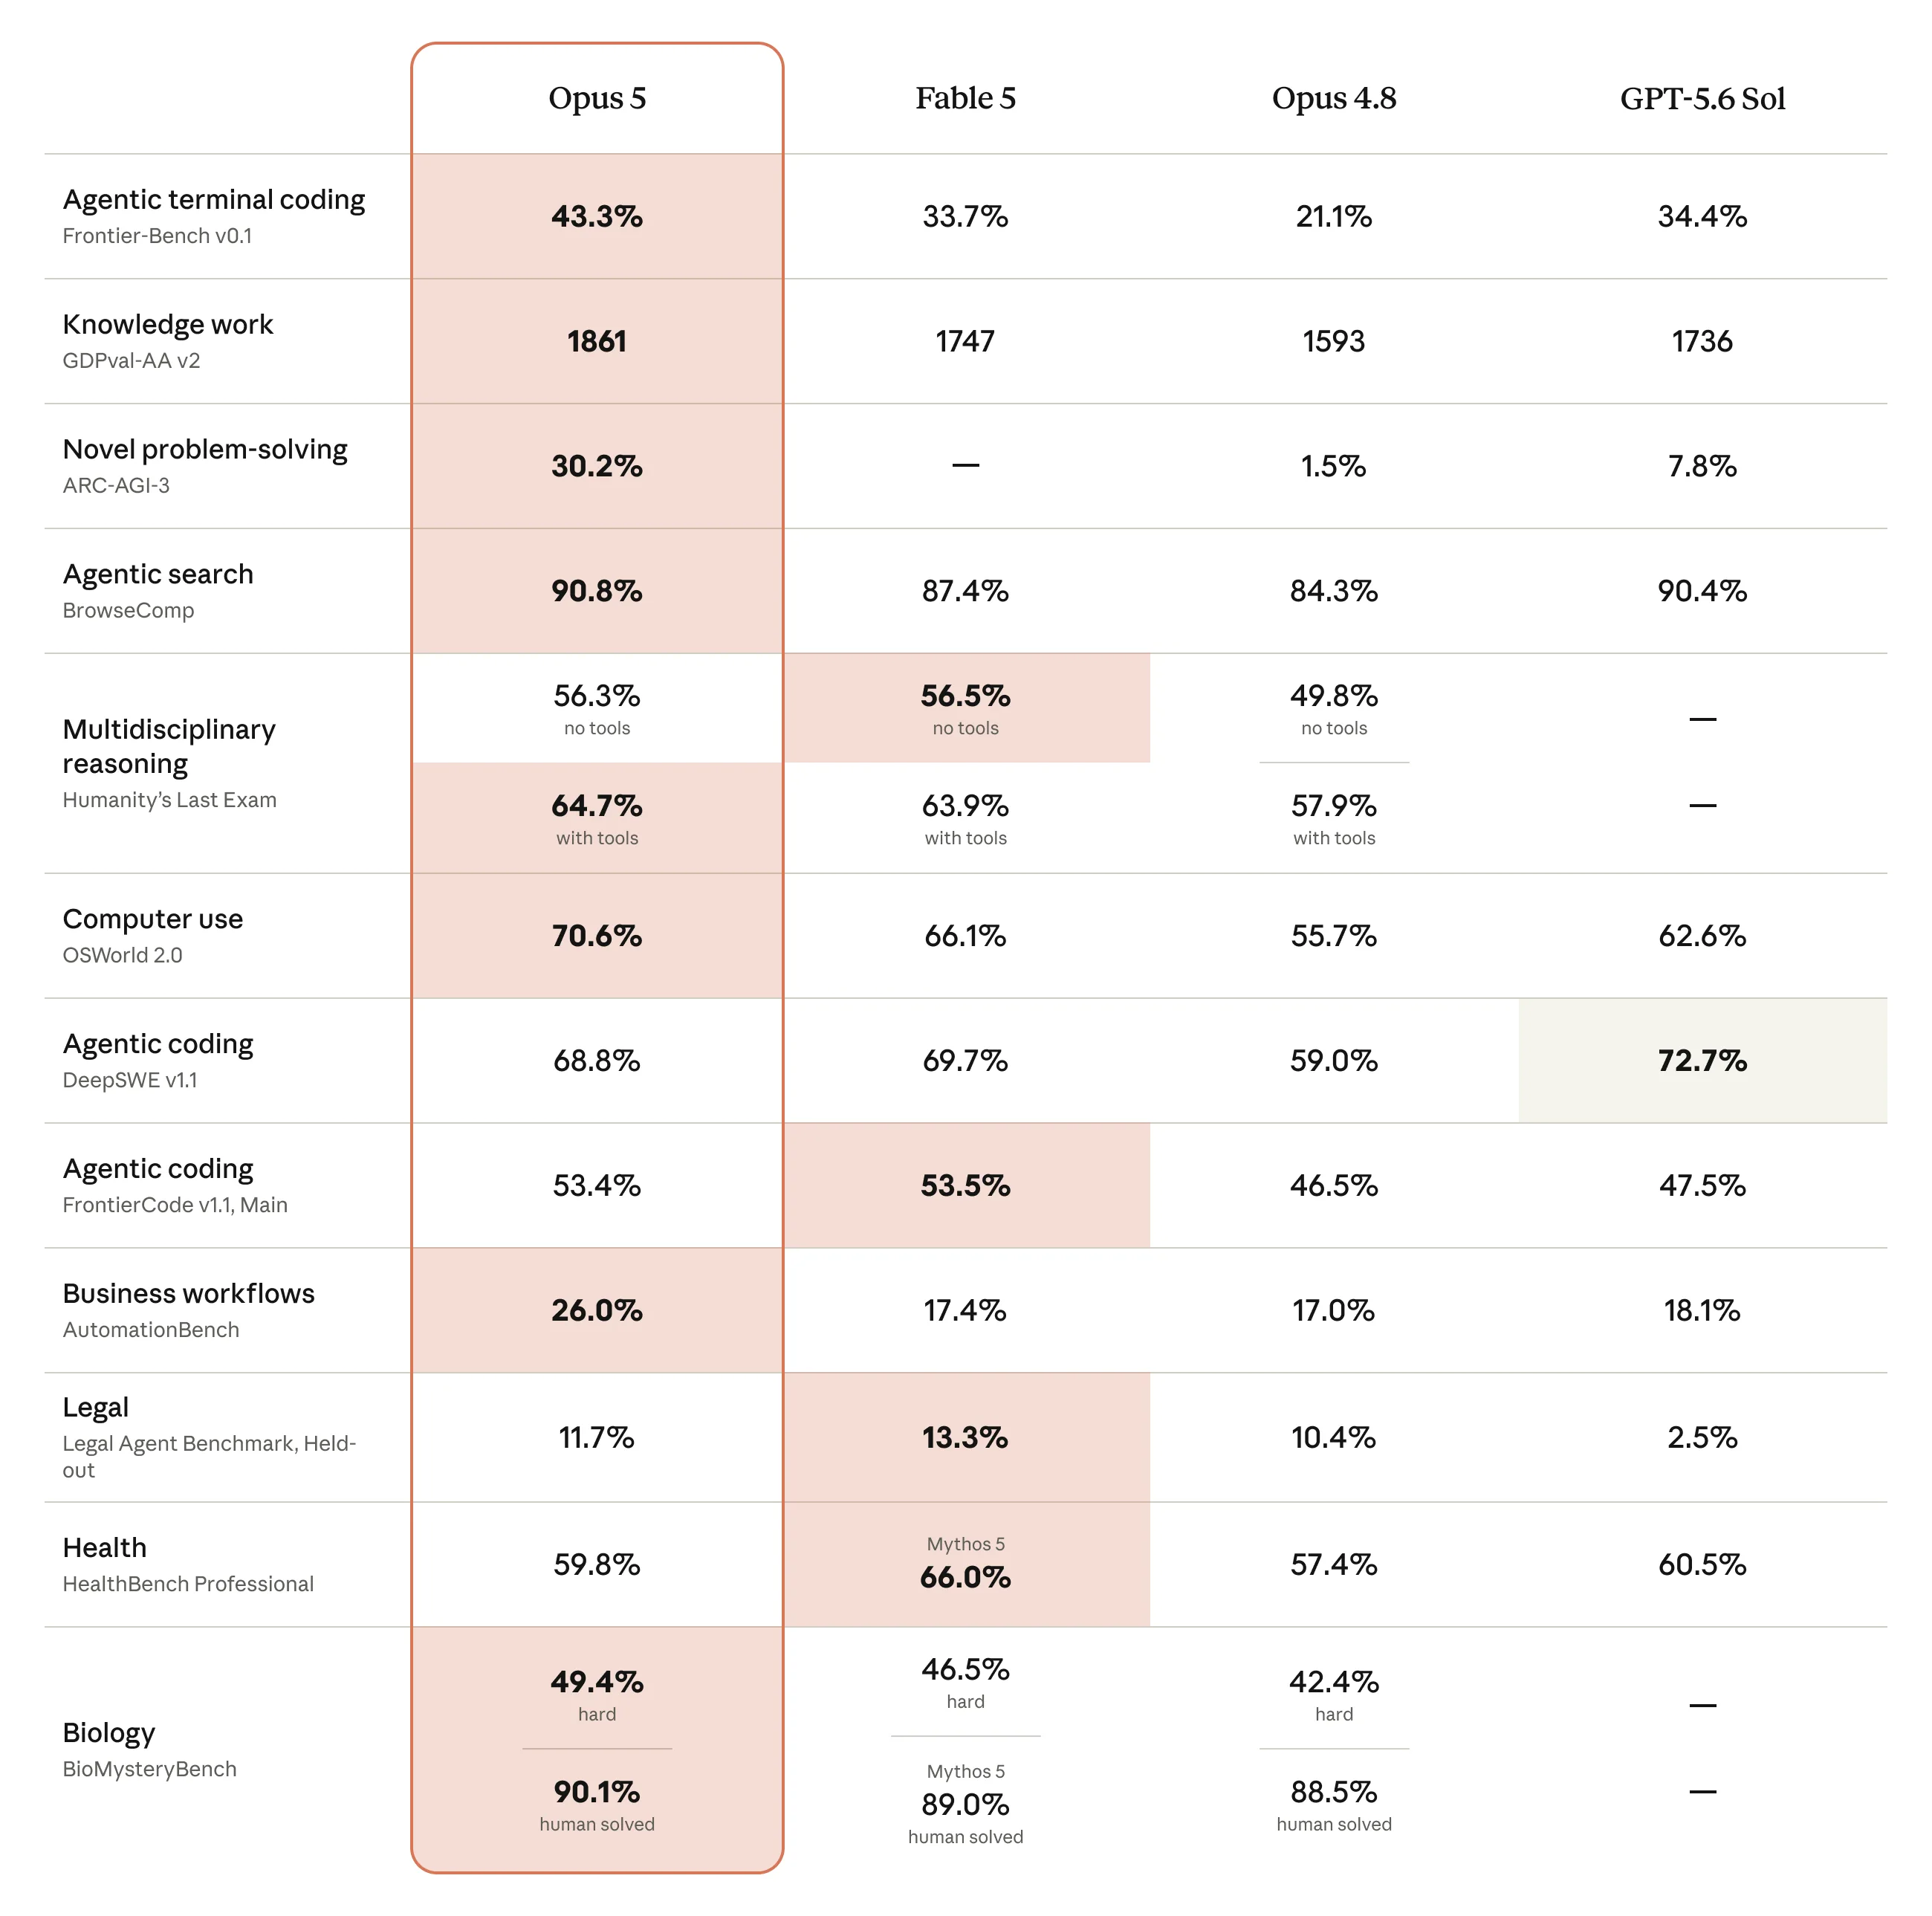
为什么官方数字会互相“不一致”?
以 GDPval‑AA 为例,Anthropic 官方图中 Opus 5 为 1861、Fable 5 为 1747、Sol 为 1736;OpenAI 发布页中的另一套表格则给出 Sol 1747.8、Fable 1759.6。差异可能来自评测版本、运行时间、模型快照、工具与 harness、采样数或裁判配置。它不必然意味着谁“造假”,而是说明模型榜单从来不是物理常数。
Artificial Analysis 在发布前获得 Anthropic 支持进行测试,结果相对独立于厂商官网,但仍不是绝对中立的“宇宙真理”。其结论值得注意:Opus 5 max 在综合智能和知识工作上领先,编码 Agent 指数并列第一;但 Fable 5 在事实知识上仍更强,GPT‑5.6 家族在较低 effort 时经常位于更好的成本—能力前沿。
把模型放回真实任务,区别才会显现
1. 复杂编码与代码审查
Opus 5 很可能是新的默认优先项。它在 Agent 编码、代码审查、根因定位、补测试和长任务收尾之间取得了较好平衡;Fable 5 更适合极难架构、陌生系统和必须榨取最后一点上限的任务;Sol 则在终端、Apply Patch、Hosted Shell、文件和多 Agent 配合中占据系统优势。值得注意的是,OpenAI 自己公布的 SWE‑Bench Pro 中 Fable 明显领先 Sol,而 TerminalBench 又是 Sol 更强——“编码强”本身就不是单一能力。
2. 深度研究与知识工作
如果任务是数小时到数天的研究、科学推理、跨文档综合,Fable 5 的上限仍然最有吸引力。Opus 5 在知识工作 Elo 上更突出,且成本更适合频繁使用;Sol 在需要边搜索、边运行代码、边生成表格、图片、幻灯片和最终可编辑文件时更完整。事实敏感任务三者都不能“裸答”:必须绑定一手来源、证据台账和人工复核。
3. 浏览器、电脑操作与跨应用流程
Sol 的核心优势最明显。OpenAI 把网页搜索、文件搜索、Computer Use、MCP、Tool Search、多智能体和图像生成统一在同一产品栈里。Opus 5 的 OSWorld 和 AutomationBench 表现说明模型自身的操作判断非常强,但企业能否真正用好,仍取决于其工具环境、权限控制和可观测性。
4. 演示文档、可视化与可编辑交付物
Sol 官方强调 design judgment 和 polished editable artifacts。下面这张图是 OpenAI 发布页展示的模型生成幻灯片示例:它不是能力基准,也使用明确标注的合成数据,但体现了 OpenAI 把“回答”推进到“可编辑成品”的产品方向。
5. 高风险决策
医疗、法律、投资、监管与安全任务,不应该直接按“最强模型”采购。应优先看来源可追溯、工具权限、拒答与回退机制、数据保留、人工审批和结果验收。Fable 的更强安全分类、Opus 的较低摩擦、Sol 的广泛工具面,各有不同风险:一个可能过度阻断,一个可能过度主动,一个可能拥有过多执行面。
Token 价格只是发票的第一行
如果一个便宜模型需要三次重试、两轮人工纠错和一次返工,而一个更贵模型一次通过,后者可能才是低成本模型。
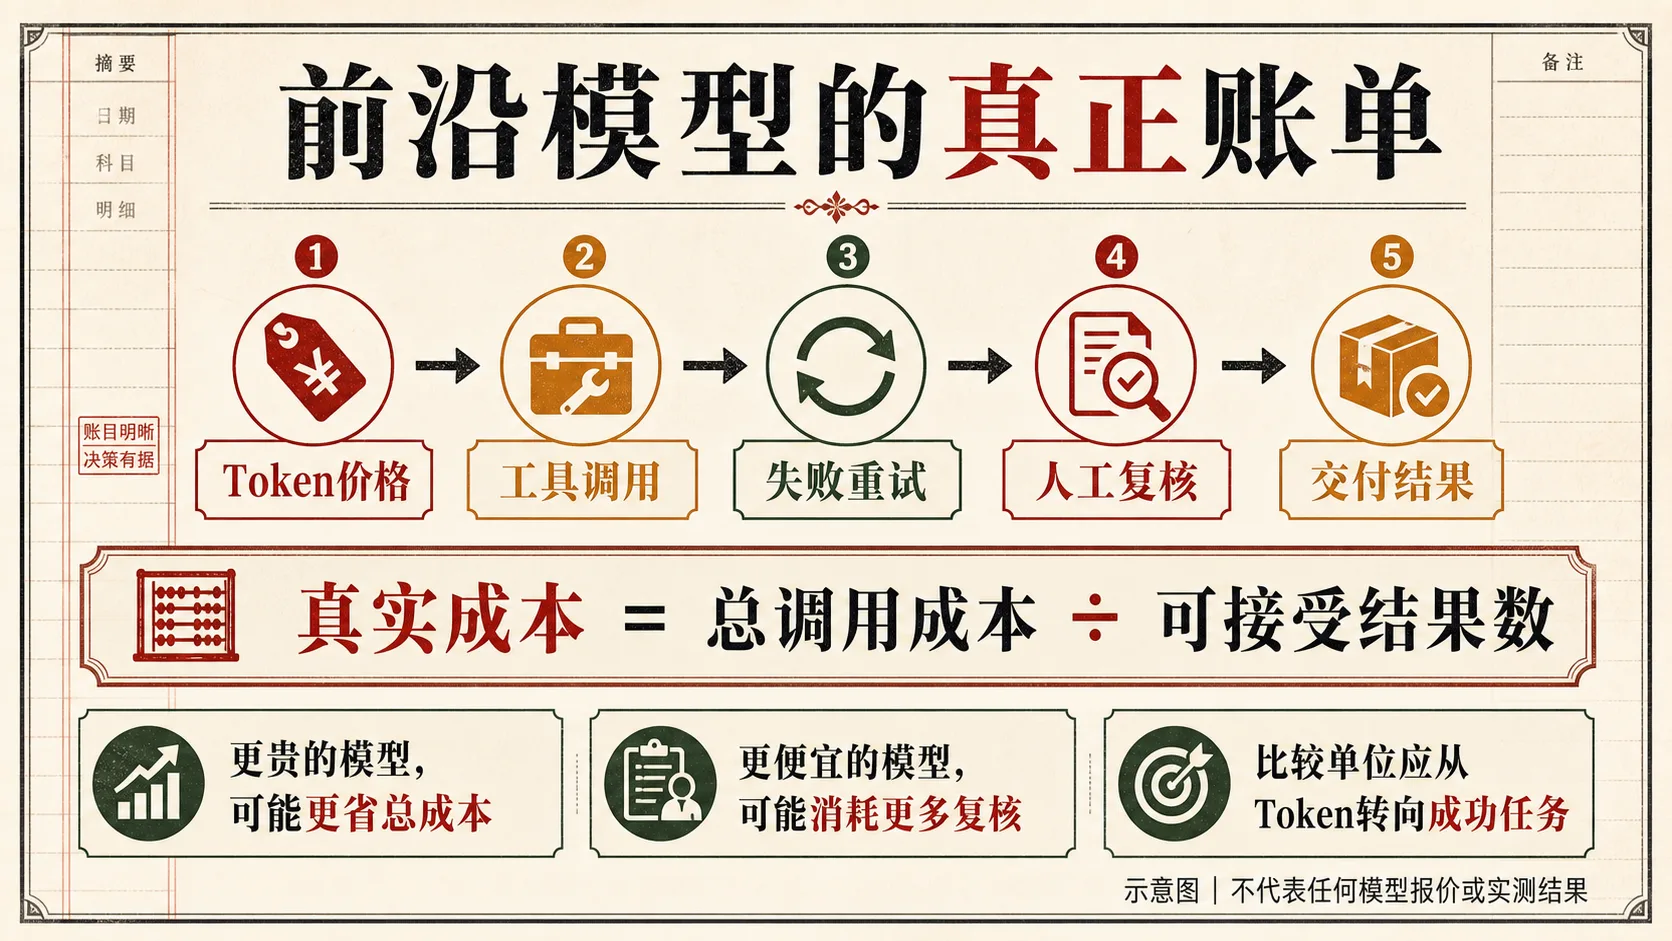
Opus 5 的战略冲击正在这里:它不是单纯把 Token 降价,而是试图在更低单位价格下维持较高的一次完成率。Anthropic 在 CursorBench 中强调其 max 得分接近 Fable 峰值,但每任务成本更低;Artificial Analysis 又提醒我们,在低 effort 区间 GPT‑5.6 家族可能拥有更好的成本—智能组合。两者并不矛盾,因为不同任务、不同 effort 会得到不同最优点。
企业真正应该跟踪四个指标:
当模型进入代码合并、数据分析、客户沟通和业务操作,D 往往比 A、B、C 都大。此时最优选型可能不是“平均最聪明”,而是“失败模式最可控”。
什么任务该选谁?
超长周期科研、极难数学与工程、陌生领域探索、少量高价值任务、失败成本高且预算充足。
复杂代码库、代码审查、企业知识工作、流程自动化、要求主动验证和稳定收尾的日常重任务。
需要浏览、电脑操作、终端、文件、图像、MCP、可编辑文档或多智能体共同完成的端到端任务。
高风险或大规模场景先做自己的评测集;事实任务绑定检索,执行任务绑定权限、回滚和人工门禁。
一套比看排行榜更可靠的 20 题实测法
最终得到的不是“模型总分”,而是一张任务路由表。真正成熟的企业不会只买一个冠军模型,而会把不同模型放进不同风险、成本和能力层级。
安全、回退与可用性,已经成为性能的一部分
Fable 5 发布后三天曾因美国出口管制相关问题暂停访问,7月1日才恢复。这段经历说明:模型能否持续获得、在哪些地区可用、会不会被政策突然切断,已经与价格和榜单同样重要。
Anthropic 对 Fable 5 的产品化采用安全分类器:网络安全、生物化学、模型蒸馏等敏感请求可能路由到 Opus 4.8。Opus 5 的安全干预率按 Anthropic 口径比 Fable 低约85%,但标记请求仍可能回退。结果是:你在同一个产品名称下获得的回答,可能并不总来自同一模型。
Sol 也不能只看模型卡。其能力依赖 OpenAI 的 Responses API、工具权限、组织设置、地区政策和数据控制。工具越多,潜在价值越大,同时权限面、数据面和误操作面也越大。
| 采购时必须问 | 为什么重要 |
|---|---|
| 是否会自动回退到其他模型? | 影响一致性、可解释性、成本和安全评估。 |
| 工具调用是否纳入零数据保留? | 模型本身 ZDR 不代表外部工具、日志与附件也自动 ZDR。 |
| 长任务如何压缩上下文? | 压缩、持久笔记和记忆策略会改变结果,不只是上下文窗口。 |
| 哪些动作需要人工确认? | 浏览与分析可以自动,付款、发送、发布、删除和部署通常需要更高门禁。 |
| 中断、重试和回滚怎么做? | 自主性越强,失败恢复机制越重要。 |
前沿模型市场,正在从“单一王者”变成三层结构
Opus 5 最重要的行业意义,是证明前沿能力不再只存在于最高价模型。能力开始像云计算资源一样,被拆成不同 effort、速度、工具和安全等级,按任务动态调度。
第一层:少量极限任务,继续追逐能力上限
Fable 5 这样的模型不会消失。科研、复杂架构、最难推理和未知问题仍愿意为最后几个百分点付出高价。它更像超算中心:不是所有人每天都用,但决定能力边界。
第二层:大多数高价值任务,转向生产前沿
Opus 5 最可能改变的是这一层。它会推动企业把更多复杂代码审查、分析、流程编排和知识工作从“试验”搬进“默认生产”。如果实际一次完成率和官方口径接近,它带来的不是替代一个模型,而是扩大整个前沿模型可用市场。
第三层:工具系统决定最终体验
Sol 代表的路线会持续增强。模型差距缩小以后,浏览器能不能操作、文件能不能编辑、终端能不能跑、工具能不能搜索、多智能体能不能协作、权限和证据能不能管理,会比单项分数更影响用户选择。
但这不是永久排名。Opus 5 的事实可靠性仍需更多独立验证,Fable 5 的政策可用性和成本仍是现实变量,Sol 的系统优势也依赖具体工具和权限配置。三个月后,最值得关注的不是谁又多赢一张榜单,而是三件事:
从演示走向大规模真实任务后,一次验收通过率还能不能维持。
高 effort、工具、重试和人工复核计入后,每个成功任务是否更便宜。
模型越主动,企业能否设置边界、停止条件、证据和回滚。
当基础模型越来越接近,运行时、工具、数据和工作流会不会成为真正护城河。
哪些是事实,哪些是厂商主张,哪些是本文判断
本文把证据分为三类:厂商资料 只证明厂商公开了什么;独立测评 用于交叉比对,但仍受 harness 与合作关系影响;作者分析 是基于前两类材料形成的产品与行业判断。
- Anthropic|Introducing Claude Opus 5(2026-07-24)
- Anthropic API Docs|Models overview(价格、上下文、输出、知识截止)
- Anthropic Docs|Prompting Claude Opus 5(主动性、委派、验证与提示建议)
- Anthropic|Claude Fable 5 and Mythos 5(2026-06-09)
- Anthropic|Redeploying Fable 5(访问恢复与政策背景)
- OpenAI|Introducing GPT‑5.6(2026-07-09)
- OpenAI API Docs|GPT‑5.6 Sol(价格、上下文、工具与长上下文计费)
- Artificial Analysis|Opus 5 analysis(综合指数、成本、知识工作与事实性测试)
吴兆华|拓拔野的随笔
长期关注 AI、Agent、数字信任与产业变化。本文不是模型厂商广告,也不构成采购、投资或技术承诺。希望做的,是把榜单背后的产品逻辑讲清楚。
e签宝 吴兆华:13967449069
邮箱:tuobaye@tsign.cn