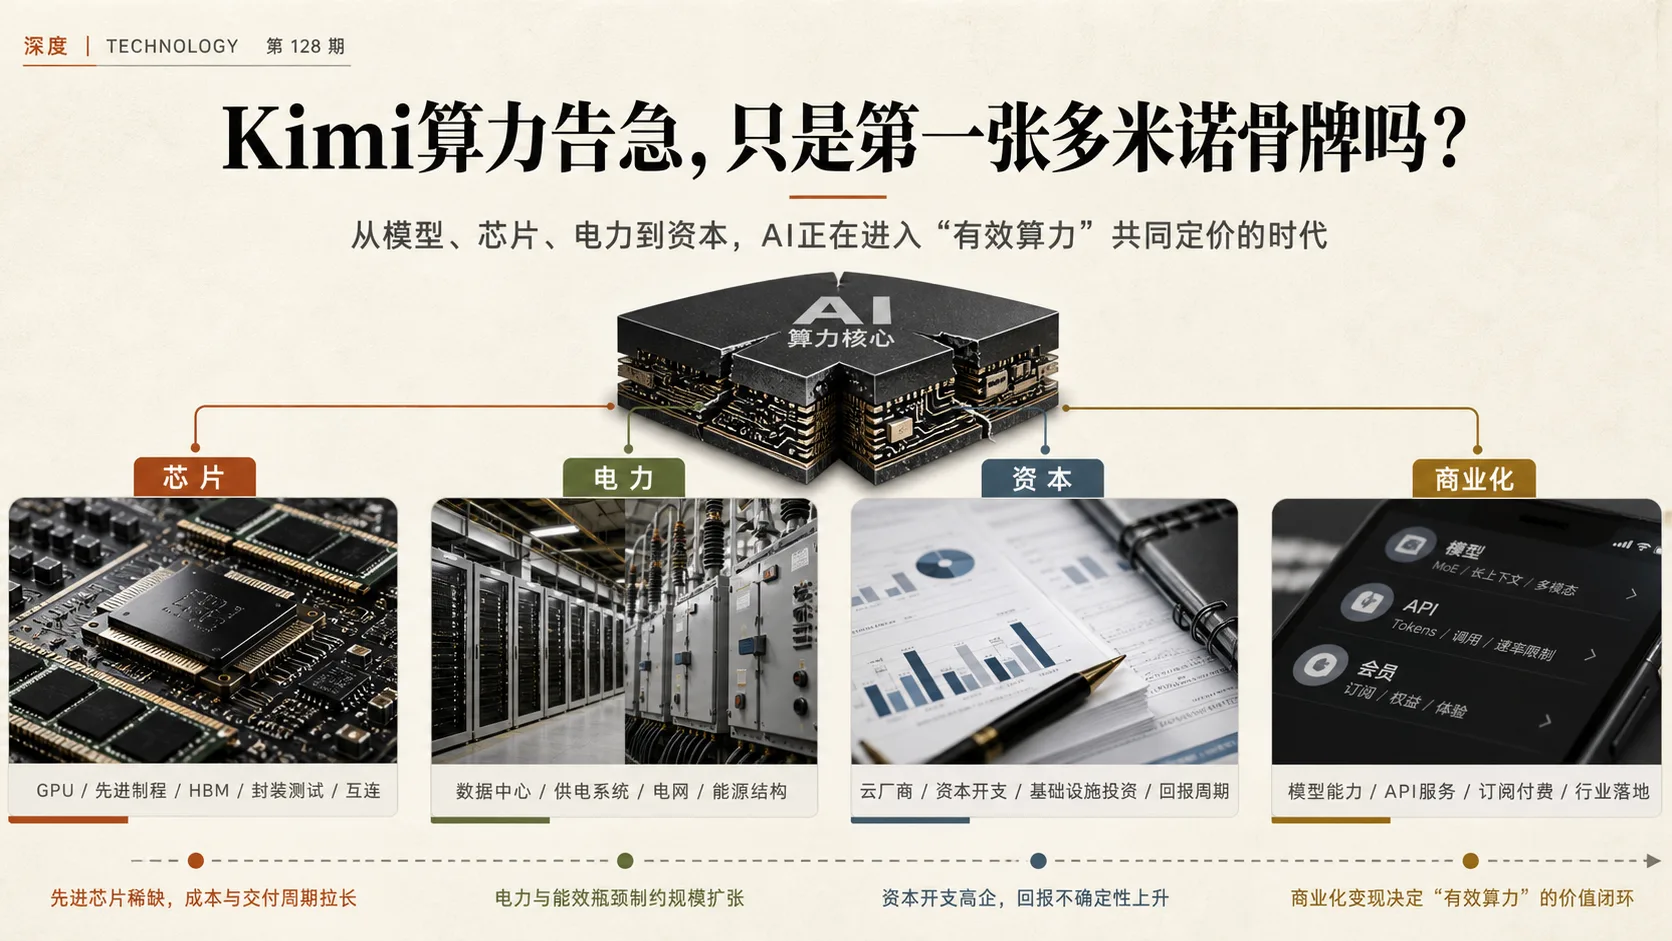
7月19日,Kimi做了一件互联网公司通常不愿做的事:当用户正在涌入,它却先关掉了新会员的付费入口。理由不是卖不动,而是请求量在48小时内逼近了现有集群上限。
一家AI公司在新品请求量快速攀升后,暂停接收新的C端会员订阅,看起来像一则极具传播性的公司新闻。但如果把视野从Kimi拉远,它更像一只罩中的金丝雀:当AI从聊天变成长时间思考、写代码、调工具的Agent,模型公司竞争的已不只是“谁更聪明”,而是“谁能长期供养这种聪明”。
纸面FLOPS、零散机柜和能稳定跑某个模型的低时延集群,是三件不同的事。
中国叠加先进芯片、异构迁移与软件生态约束;美国更受电力、并网、HBM和建设周期约束。
上游先确认订单,云厂商先支出现金,模型公司最后才用会员和API慢慢回收。
先别急着把一家公司,写成整个行业
Kimi官方公告能够证明三件事:K3发布后请求量超出预估;现有集群已经接近承载上限;公司选择优先保障存量付费用户,同时扩容并重做主权益与Code权益的分配。
但它不能证明“中国大模型已经无卡可用”,也不能证明Kimi的资金链、芯片数量、云合同或单位Token成本。它是一次真实的压力测试,不是一张全行业的CT片。
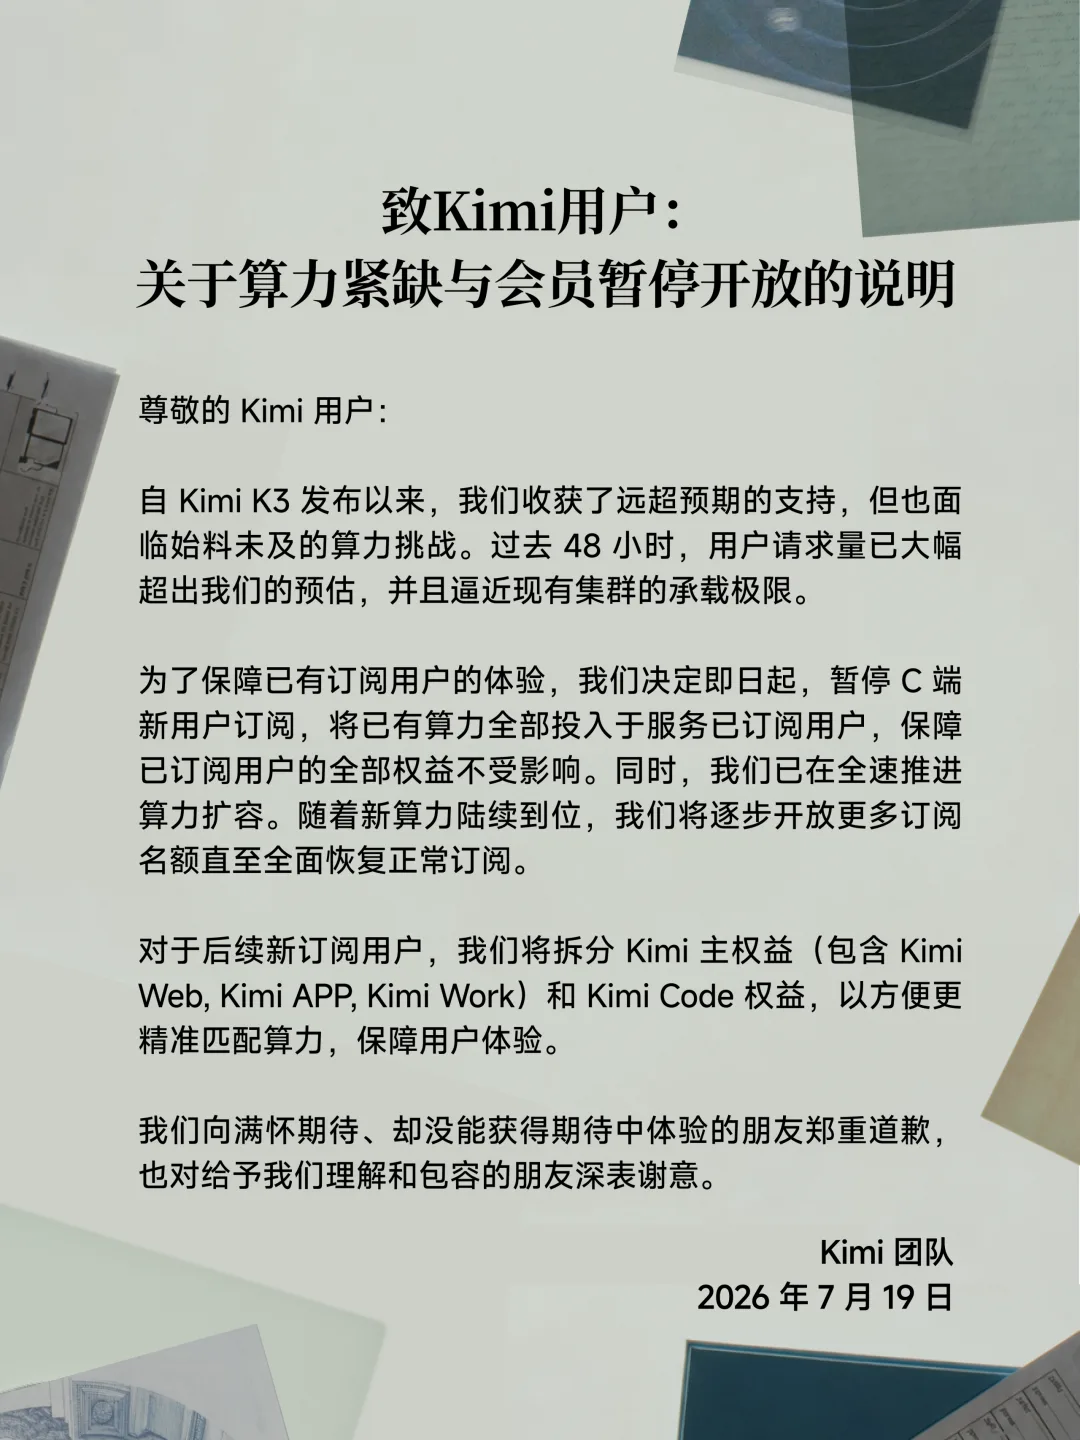
一张公告里,有三层不同的信息
产品层:新模型成为爆款,用户从“尝试”走向“持续执行”。
工程层:扩容不只是加几张卡,还要完成网络、显存、调度、缓存与故障恢复。
商业层:固定月费无法无限覆盖长上下文、深度推理和Agent长任务的可变成本。
暂停的是C端新会员订阅,存量会员优先保障;官方正在扩容,但未公布恢复日期与硬件规模。
Kimi是中国独立模型公司中较早把“产品增长—有效算力—定价”矛盾显性化的样本。
缺口主要来自芯片、云额度、并发洪峰、部署效率还是商业上主动止损,官方尚未拆分。
一个数据中心有卡,不等于你此刻就能用
讨论AI算力最容易犯的错,是把所有FLOPS当成同一种商品。某个地方可能存在未充分上架的机柜,一家头部模型公司却仍在高峰期限流。这两件事不矛盾:模型需要的是特定芯片、足够HBM、高速互联、成熟软件栈、低时延网络与稳定电力同时到位。
算力紧张,其实有四种
四种短缺会在不同环节共同压缩用户可感知的有效算力。
能否拿到合适的GPU、ASIC、HBM与先进封装产能。
有卡之后,网络、显存、存储与调度能否将它组成一台AI工厂。
日常够用,不代表新模型发布、爆款传播和Agent长任务时仍有冗余。
算力客观存在,但价格、长期承诺或单位任务成本让商业模式无法承受。
从纸面算力到用户可感知的有效算力
每经过一层,可立即调用的供给都可能缩小。
国家数据局披露,2025年我国智能算力规模已达159万PFLOPS(FP16);但“东数西算”官方材料同时强调供需匹配、异构调度、网络成本和绿电协同。总量增长与局部紧张可以同时成立。[1][2]
你只提了一个要求,后台却可能已经跑了上百次
大模型的使用单位正在变。聊天时代,平台主要估算一次输入和输出有多少Token;Agent时代,用户的一句话会展开为规划、搜索、阅读、写代码、执行、报错、重试、校验和汇总。每一轮都要占用上下文、KV Cache、显存、网络与推理时间。
总参数只是一个因素;实际激活参数、上下文、推理长度、缓存命中与失败重试同样重要。
参数大,不等于每次请求都按总参数计费
MoE、量化、蒸馏和投机解码已经打破简单的线性关系。
DeepSeek-V3为671B总参数,单Token激活37B,说明总参数不是单次计算量。
百万Token仓库、长文档和多轮对话会放大显存与缓存压力。
推理时计算可以换来更好答案,也会直接增加占卡时间。
搜索、编译、测试、浏览器操作与重试,会把一次请求展开成一条任务链。
为了高峰不排队,平台必须保留冗余;已卖出的体验本身也有成本。
这正是Kimi事件最具行业意义的地方:训练一个模型是取得入场券,长期为大量用户提供推理才是现金流考试。K3越能承接复杂任务、用户越愿意把长任务交给它,对高质量有效算力的需求就越集中。
全世界都缺,但缺的不是同一环
美国企业获取最先进加速器的政策与供应条件总体更有利,却同样缺能够立刻投入运行的完整系统。微软公开表示AI需求再次超过供给,即使它计划在两年内将数据中心占地大致翻倍;Alphabet将2026年资本开支指引提到1750亿—1850亿美元,仍承认云业务运行在紧供给环境中。[6][7]
中美都在缺有效算力,但压力结构不同
这是产业链判断,不是简单的国家强弱排名。
中国:可用质量与生态迁移
总体算力快速增长,但高端集群、供应连续性与模型迁移成本同时约束。
- 先进芯片与HBM供应不确定出口许可政策可直接改变可购产品。
- 异构芯片难以无损拼成资源池编译器、算子、框架和引擎需重新适配。
- 西部电力与东部低时延需求错位训练可以远离用户,交互式Agent更容易受网络影响。
- 独立模型公司资产负债表更薄无法像巨头一样用广告、电商或云现金流长期补贴。
美国:物理建设速度跟不上资本
先进芯片和融资通道更强,但电力、土地、并网、变压器、建设与HBM仍无法瞬间完成。
- 数千亿美元Capex并未消除紧张云厂商仍多次披露需求超过容量。
- 电网与设备交付成为新瓶颈变压器和电缆等待期延长,输电项目需多年。
- 长期算力合同成为新融资方式模型公司用多年最低消费锁定容量。
- 折旧与利用率风险继续后移现金已支出,AI收入与利润还要在数年内证明。
数据中心的电力需求,已不是一个边缘指标
国际能源署统计和美国能源部预测,应注意口径不完全一致。
IEA估算2024年全球数据中心用电为415 TWh,占全球用电约1.5%,到2030年可能接近945 TWh;并警告如果不解决电网风险,约20%的已规划数据中心项目可能延误。美国能源部则估算,美国数据中心用电占比可从2023年的4.4%上升到2028年的6.7%—12%。[3][4]
前沿模型中心可能是中美两极,但AI供应链从来不只有两个国家
模型竞争、芯片代工、HBM、设备材料、能源与资本是一张全球网。
用户多点了几次“深度思考”,为什么最后会传导到电网与资本市场
AI产业链不是一条“模型火了、GPU上涨”的简单直线。真正的链条从任务形态开始:用户需要更长上下文、更多推理步数、更高并发与更稳定SLA,模型公司因而锁定长期算力;云厂商再将需求变成GPU、HBM、网络、机房、电力和冷却的资本开支。
从一次Agent任务,到一座AI工厂
订单和现金流在各环节的确认时点并不一致。
同一条链上,有三只走速不同的钟
这是判断“AI收入增长”是否有质量的关键。
GPU、服务器、变压器与数据中心需要立即下单、预付或签长期合同。
现金先流出,设备折旧在数年内进入利润表;具体年限以各公司会计政策为准,芯片迭代还可能快于折旧期。
消费者会员按月取消,API用量会波动,企业AI项目的收入确认又比建设更慢。
这就是最值得警惕的期限错配:模型公司为了避免下一次Kimi式容量告急,要提前锁定明天的算力;但明天的用户是否付费、付多少、会不会被更便宜的模型分流,并不确定。因此,“用户越多”与“现金流越好”在AI时代不再自动画等号。
微软2026财年第一季度就展示了这种压力:Microsoft Cloud毛利率为68%,同比下降的重要原因是AI基础设施投入。这不代表AI投资错了,而是说明大规模资本开支会先压低自由现金流;资产投入运行后,折旧再逐步进入成本并对毛利形成压力,回报要等未来收入慢慢验证。[6]
不是“所有大模型公司”,而是同时满足这些条件的公司
判断谁会遭遇类似压力,不能只看模型参数,而要看用户强度、计价方式、算力来源和资产负债表。一家有自有云、广告或电商现金流的巨头,可以用内部补贴延长时间;独立实验室、C端爆款与重度Agent却会更早暴露冲突。
“下一个Kimi”风险矩阵
这不是公司黑名单,而是一组可验证的业务特征。
缺少自有云与稳定现金牛,重度用户的边际成本可远高于平均月费。
长上下文、长输出、多工具和失败重试使单任务方差极大。
模型发布、媒体传播与竞品故障可在数小时内制造超过压测曲线的洪峰。
供应、政策、价格、网络或机房故障会直接传导到产品层。
将成本与用量绑定,并用大小模型、缓存、批处理降低单任务成本。
收入可预测,容量可规划,成本可进入项目报价与SLA协商。
后续其他厂商未必也会“暂停收钱”。同一种压力可能表现为每日额度下调、高峰排队、大小模型动态路由、Code/Agent单独收费、API Priority溢价、企业客户优先或与云厂商签订长期容量。形式不同,本质都是在回答同一个问题:稀缺的高质量算力应该先分给谁?
“卖铲子”也不是躺赢,关键看订单、瓶颈与现金
算力紧张会把需求向上游传导,但不代表所有带有“AI算力”标签的公司都能留住利润。稀缺环节通常最早拿到订单,后来者却可能在扩产完成时遇上需求放缓、价格下降或技术路线变更。
| 环节 | 需求从哪来 | 什么才是真正的受益 | 主要风险 |
|---|---|---|---|
| 加速芯片/ASIC | 训练、推理与超节点扩张 | 产品实际上架、软件生态完整、客户可复购 | 产品切换、出口政策、客户自研芯片 |
| HBM/先进封装 | 高带宽存储与高端加速器交付 | 长单、良率、客户认证与产能爬坡 | 集中扩产后的周期性与价格回落 |
| 交换/光模块/网络 | 超大集群中的东西向流量 | 进入主流集群架构并形成稳定订单 | 光电技术路线变化、客户集中与价格压力 |
| 电力设备/液冷 | 高密度机柜、并网与能效约束 | 交付周期、服务能力和在手订单能见度 | 项目延迟、标准不统一、产能扩张后竞争 |
| IDC/电网/发电 | 长期基荷、高峰调节与算电协同 | 接电、上架率、长约客户和可控融资成本 | 重资产、审批、社区阻力、利率和利用率 |
| 推理优化软件 | 同一瓦电、同一美元产出更多智能 | 量化、缓存、调度、路由能够直接降低客户成本 | 功能被云厂商和模型厂商内置 |
| 基础设施金融 | 超长期、巨额、前置的AI建设支出 | 有长约客户、优质抵押物和明确成本分担机制 | 设备过时快于债务期限,需求不及预期 |
对投资者而言,真正值得追问的不是“它是不是AI算力概念”,而是四个问题:订单是否真实、产能是否稀缺、利润能否留下、现金何时回来。上游景气与股东回报之间,还隔着产能、议价、资本开支和周期位置。
算力成本会下降,但整个行业未必会少花钱
效率提升不会自动结束算力紧张。当单价下降,更多用户会把更长、更复杂、以前不值得做的任务交给AI;从文字扩张到视频、代码、科研与多Agent协作,总需求很可能比单位成本下降更快。这是AI版的杰文斯效应。
四种情景,将决定谁拿到下一轮利润
不是预言唯一未来,而是为不同经营与投资决策建立观察框架。
芯片和软件效率提升,Agent、视频与多模态需求增长更快,瓶颈在GPU、HBM、网络、电力间轮转。
蒸馏、量化、缓存和定制芯片让成本降得更快,价值向拥有数据、用户入口与行业流程的应用转移。
企业项目难以量化产出,云厂商放缓后续订单,上游从紧供给转向局部过剩,模型公司削减免费额度。
国产芯片、超节点、编译器、框架与异构调度协同进步;应用扩张,但缺钱和差异化的独立模型公司反而更容易整合。
上一阶段,AI公司竞争的是谁能做出更聪明的模型;下一阶段,竞争的是谁能长期供养这个模型。
决定胜负的不再只有算法,而是算法、芯片、电力、资本与商业化能否形成闭环。如果要判断这条产业链,我会长期盯住这10个信号
这是紧供给最直接的经营层证据。
影响未来折旧速度与产品过时风险。
决定资本开支是在扩张护城河,还是先变成利润压力。
收入与现金回报是两张不同的表。
这些环节的交付期和在手订单,可验证瓶颈是否真实。
不只看宣布多少GW,更要看何时真正上电、上架和负载。
软件效率能否对冲硬件紧张,要落到真实任务而不是峰值Benchmark。
产品规则的频繁调整,是单位经济性变化的外部信号。
不只看名义PFLOPS,更要看模型迁移、算子覆盖、网络效率与有效上线。
当业务越受欢迎就越需要外部融资,定价与成本闭环仍未完成。
这组仪表盘也能帮助我们区分三种完全不同的情况:真实供给紧张,公司主动优化定价,以及只有概念没有订单的炒作。公司的一则公告可以引发研究,但不应替代数据、现金流与交付事实。
Kimi是第一张骨牌吗?
不一定。它可能只是最早把压力说得够清楚的公司之一。
其他模型公司不会按照相同剧本发展。有的会限额,有的会涨价,有的会用小模型路由,有的会与云厂商结盟,有的则会把算力优先留给企业客户。但从今天开始,一家模型公司是否值得长期信任,不能只看一次模型发布,还要看它能否把算法、芯片、电力、资本与真实收入连成闭环。
会做模型,是上半场。养得起模型,才是下半场。
主要资料与核验边界
- 国家数据局:《数字中国建设2025年度报告》
- 国家数据局:“东数西算”供需、调度、网络与绿色能源政策说明
- IEA: Energy and AI, Executive Summary
- U.S. DOE: Evaluating Electricity Demand from Data Centers
- NVIDIA FY2026 Form 10-K
- Microsoft FY2026 Q1 Earnings
- Alphabet 2025 Q4 Earnings Call
- Stanford AI Index 2026: Technical Performance
- NVIDIA FY2026 Financial Results
- DeepSeek-V3 官方架构说明
- OpenAI: Learning to Reason with LLMs
- 国家能源局:算力中心用电与绿色转型
- Huawei Annual Report 2025
- Kimi K3 官方价格与使用说明
- Kimi API 官方计费文档
- Anthropic and AWS Compute Partnership
- Micron HBM4 for NVIDIA Vera Rubin
- Vertiv 2026 Q1 Results
说明:文中对Kimi的事实描述以官方公告、官方产品页与技术文档为主;对中美算力、电力与资本开支的数据使用政府、公司财报和国际能源署等一手来源。文章对产业链传导、风险特征与未来情景的部分为作者分析,不代表相关机构承诺。本文为产业研究与投资观察框架,不构成个股或证券投资建议。